产品/09.18 · 00:00/5 MIN/编译自 光子星球/0 阅读
办公AI智能体之战:从模型分销转向上下文工程
办公AI智能体竞争正从表层的模型分销转向深度的上下文工程。TeleAgent通过多模型动态调度、动态上下文压缩治理及本地长期记忆,显著降低Token消耗并提升任务交付稳定性,为桌面AI办公划出新战场。
上半年,办公AI智能体(Agent)仍是大厂AI生产力试验中的普通一环。协同办公、编程、云端与桌面端产品百花齐放,但桌面智能体究竟该以何种形态落地,行业缺乏共识。
下半年,脉络逐渐清晰:Coding是手段,解决实际办公生产力才是目的。腾讯凭借WorkBuddy收敛产品形态,阿里整合出千问办公,字节跳动则主推豆包工作。各家切入点各有侧重——有的主打一句话生成成品网页,有的发力侧边栏协同编辑。但表面上比拼的是功能形态与模型分发,底层的核心竞争正在转向上下文工程与模型调度能力。
7月亮相的星辰超级智能体TeleAgent将焦点对准上下文工程。在IDC发布的《中国企业级通用Agent产品技术评估》中,TeleAgent在任务表现维度获得满分,成本效率维度同样居前。
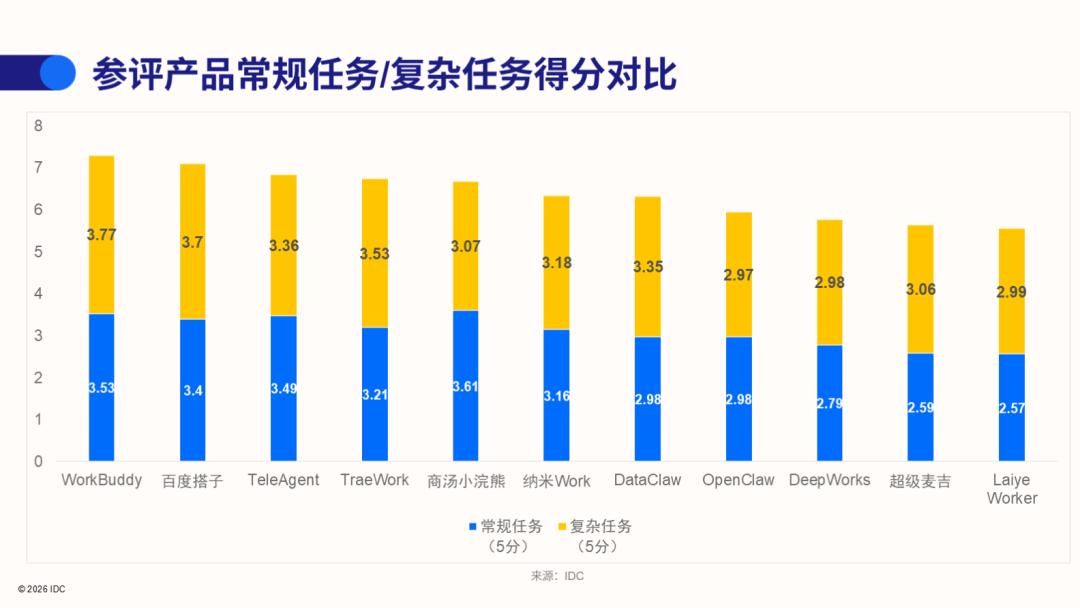
从TeleAgent的产品演化可以看出,办公AI智能体的技术重心正经历关键跃迁:从初期的“模型分销”走向“模型深度调度”,从单次任务交付走向具备长期记忆的持续演进。
从模型分销到动态调度
传统办公智能体依赖模型路由(Model Router 1.0)交付能力,主要充当聚合或自营的渠道商:
- 聚合模式允许用户手动切换混元、DeepSeek、GLM、Kimi等模型;
- 自营模式则按任务复杂度将任务硬性划分为轻量档与旗舰档。
这种分销模式的痛点在于:渠道没有护城河,且无法平衡模型服务商调用压力与运行成本,难以保证交付质量的上限。
TeleAgent在服务端引入了动态调度机制(Model Router 2.0)。在供给侧,系统根据各服务商负载自动无缝切换,组建统一能力池;在用户端,根据任务强度按轻量、均衡、旗舰三档智能分流,优化资源与Token成本。底层自研的星辰Xing4.0模型原生支持256K长上下文,可扩展至512K,针对多步骤推理、规划与工具调用进行专项强化学习与闭环调优。
解决“失忆”:动态治理与长期记忆
长程办公任务常涉及跨文件与跨系统操作,上下文规模会迅速膨胀,导致多数智能体在后半程因窗口超限而“失忆”。
TeleAgent在运行框架(Harness层)中引入动态上下文治理:
- 多级压缩:实时监控窗口水位。接近上限时,优先对历史工具调用输出轻量剪枝;若空间仍不足,专职压缩模型会对长对话进行摘要,最大化保留关键信息。
- 提示词缓存:结合缓存命中技术降低重复前缀开销。
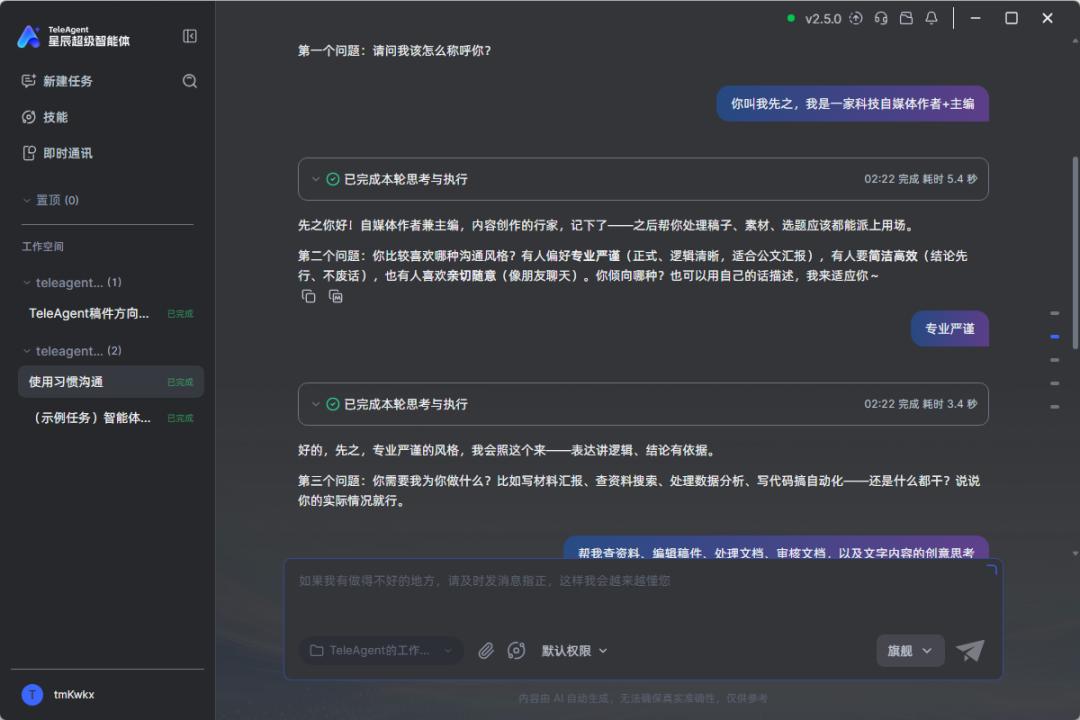
针对传统AI“跨窗口即遗忘”的缺陷,TeleAgent在桌面端搭载了autoDream长期记忆模块:每2小时自动提炼阶段日志,每24小时合并生成个人记忆档案。所有记忆在用户本地留存并可跨会话生效,智能体能够记住业务背景与个人习惯,且确保数据隐私自主可控。
工具层瘦身与按需加载
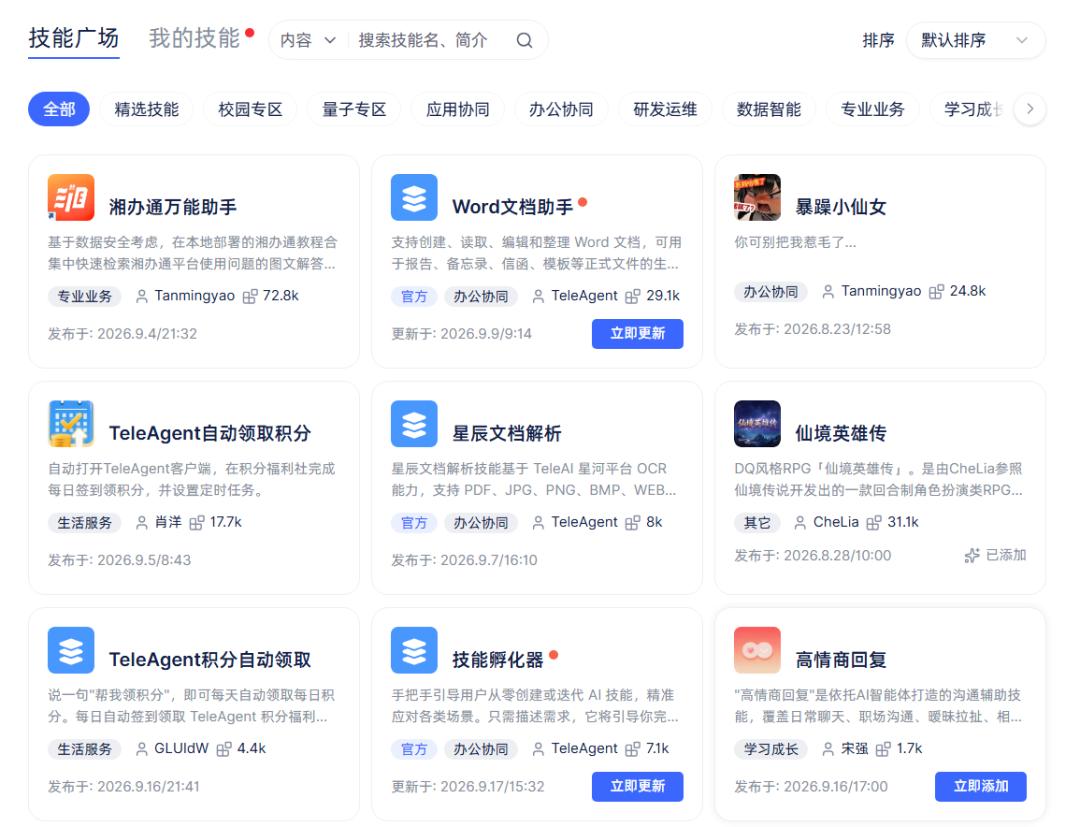
提升交付表现的另一关键在于系统提示词、工具预置与技能扩展。
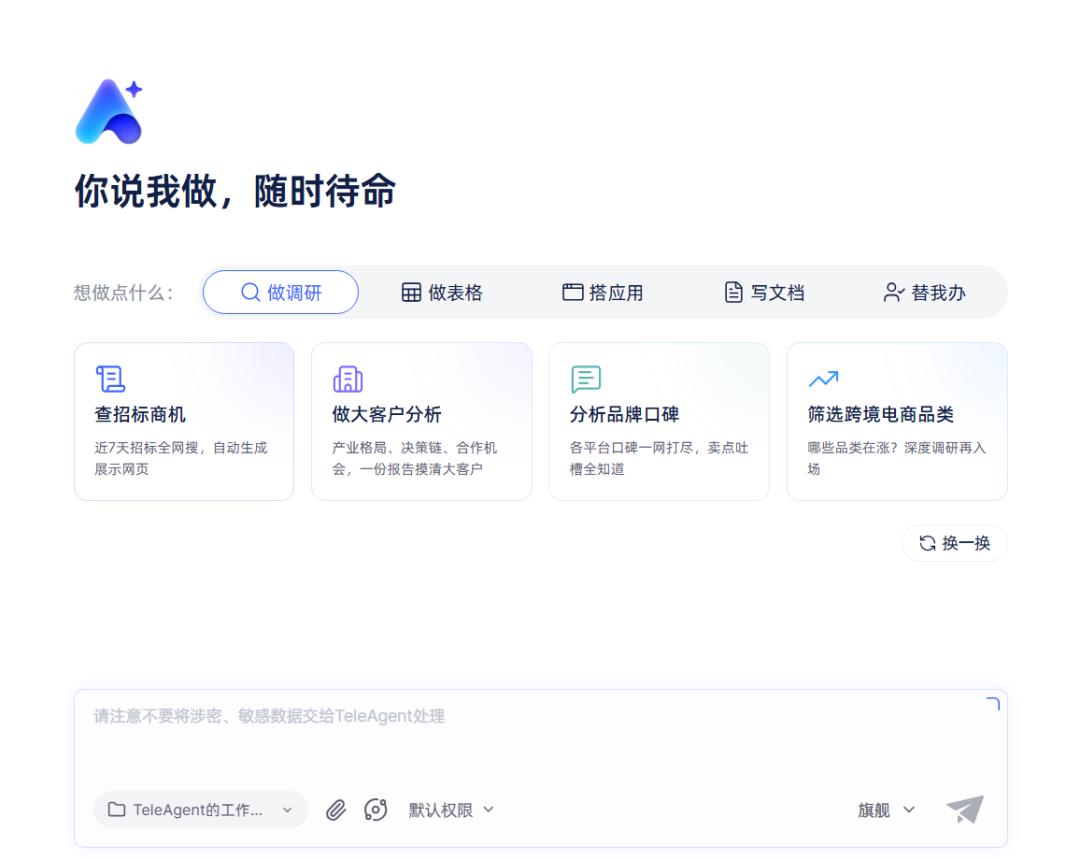
TeleAgent通过前置问答引导用户建立角色、沟通方式与边界上下文,减少空对话框带来的摸索成本。
针对海量工具导致Token过度消耗的问题,TeleAgent即将上线ToolSearch动态加载功能。该机制不再全量挂载工具,而是默认仅向上下文输入精简的工具目录,进入具体执行环节后按需检索匹配,再动态挂载对应工具,大幅压缩推理开销。
评测数据显示,TeleAgent的Token总消耗较同类产品降低约37%,代码场景节省达57%,高频办公任务平均耗时缩短至同类的75%。
筑牢企业安全红线
能力决定上限,安全合规决定应用边界。在政企、金融等对数据极为敏感的场景中,TeleAgent实行“本地读取”策略:除必要的大语言模型推理数据以Token传输外,其余处理留在本地,服务端不留存文件与落盘日志,实现数据不出域。
想了解 AI 如何助力您的企业?
免费获取企业 AI 成熟度诊断报告,发现转型机会





