洞察/09.28 · 15:37/4 MIN/编译自 AIX财经/0 阅读
AI递归自我改进概念过热,一线学者拆解真实瓶颈
RSI(递归自我改进)正成为AI行业新宠,被宣称为AI自我迭代的关键路径。然而一线学者指出,当前行业存在明显炒作,模型在端到端研发、提出有效新假设以及打通物理世界闭环上仍面临巨大挑战。
在日行千里的 AI 行业,“狼来了”的故事演进到了新阶段。过去几年这只“狼”被称为通用人工智能(AGI)或超级智能,如今它有了更具象的名字:递归自我改进(Recursive Self-Improvement,简称 RSI)。简单来说,就是让 AI 参与研发自身。
从 OpenAI 披露的“自动化研究实习生”,到 Anthropic 测量 Claude 参与内部研发的占比,再到获巨额融资的初创团队以“递归超级智能”命名,RSI 正被推向聚光灯下。但在长期研究该领域的伦敦大学学院(UCL)博士生周辉池看来,当下的火热包含不少炒作成分,学术界甚至尚未对 RSI 形成统一且清晰的定义。
周辉池是《Memento-Skills: Let Agents Design Agents》的第一作者,师从 UCL 计算机系汪军教授。他在前沿测试中发现,哪怕是当下最强大的模型,在自主科研基准测试中依然远未达到人类研究者的水平。
“AI 研发 AI”多处于局部工具阶段
传闻中“大模型修改自身训练代码、自我迭代下一代模型”的场景并未发生。当前头部大模型实验室的核心算法、研究方向和训练架构依然由人类主导。
AI 替代最快的是写代码、跑实验和看结果等中间执行环节,尚未形成端到端的自我研发闭环。即便如 Google DeepMind 或智谱等团队利用 Agent 优化推理基础设施与调度系统,其本质更多是特定指标下的局部优化。
学术界目前倾向于将相关探索划分为几个层级:
- 工具级科学研究:AI 辅助材料、药物研发或代码编写,属于将 AI 作为执行工具;
- 弱自我改进:AI 智能体根据反馈修改自身的 Prompt、记忆机制或测试套件,在既定环境内寻找更优解;
- 强 RSI:AI 自主修改底层训练代码,并在未定义的新空间中完成下一代系统的完整演进。
真正制约强 RSI 的难题并不在于“修改代码”,而在于“如何证明修改后确实变强”。如果仅是测试集分数提高,往往只是在原有环境中的过度拟合,并不代表泛化能力的提升。
真正的天花板:发现问题与物理世界验证
如果将完整的科学研发流程拆解为“找问题、提方案、写代码、跑实验、判结果、定下一步”,当前的 AI 仅在中间执行环节表现出色,但在流程首尾存在明显短板。
首先是提出真正有价值的新问题。基于预测下一个 Token 的大语言模型更擅长在人类已有的知识空间里缝补,做渐进式改进(Incremental Improvement),极难跨出已知框架,探索人类未知的空白地带。
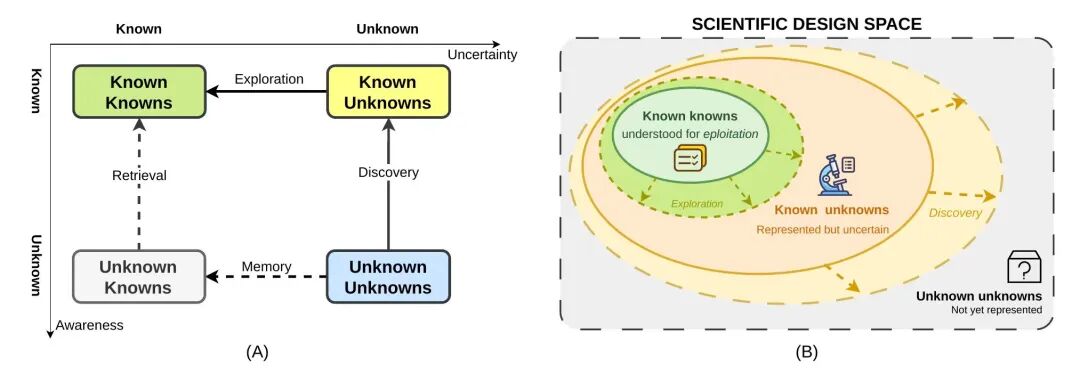
其次是连接物理世界的反馈闭环。纯软件环境容易提供密集且低成本的反馈,但科学研究的核心突破往往需要穿透到现实世界。尽管 Anthropic 等团队正在尝试让 Claude 控制液体处理等硬件设备,但面对真实物理世界的不确定性与意外误差,打通“提出假设—设计实验—操作硬件—获取反馈—持续修正”的端到端闭环,至少仍需要数年时间。
研究员角色重塑与失控担忧
随着自动化执行工具的普及,AI 研究员的日常工作正在发生分化。繁杂的 Debug 与脚本编写被压缩,研究人员需要把更多精力放在高维度的方向判断、实验评审与选题构思上。
对于舆论热议的“AI 失控”风险,一线研究者认为短期内该风险被过度渲染。当前的 AI 缺乏自我意识,更接近一个高效的数字执行器。更现实的挑战在于算力消耗、垂直领域高质量反馈环境的构建,以及权限放大后带来的数字安全与隐私隐患。
想了解 AI 如何助力您的企业?
免费获取企业 AI 成熟度诊断报告,发现转型机会


